AI có thực sự quên, hay chỉ đang che giấu những gì đã học?
Khi dữ liệu cá nhân được yêu cầu xóa khỏi hệ thống AI, liệu thông tin đó có thực sự biến mất?
Khi AI được yêu cầu quên đi
Các mô hình AI, đặc biệt là mô hình ngôn ngữ lớn (LLM) đứng sau những công cụ như ChatGPT và Gemini, được huấn luyện trên lượng dữ liệu khổng lồ. Trong quá trình đó, chúng có thể tiếp nhận thông tin cá nhân hoặc dữ liệu nhạy cảm.
Khi những thông tin này cần được xóa bỏ, việc khiến mô hình ngừng ghi nhớ hoặc tiết lộ chúng không đơn giản như xóa một tệp khỏi máy tính.
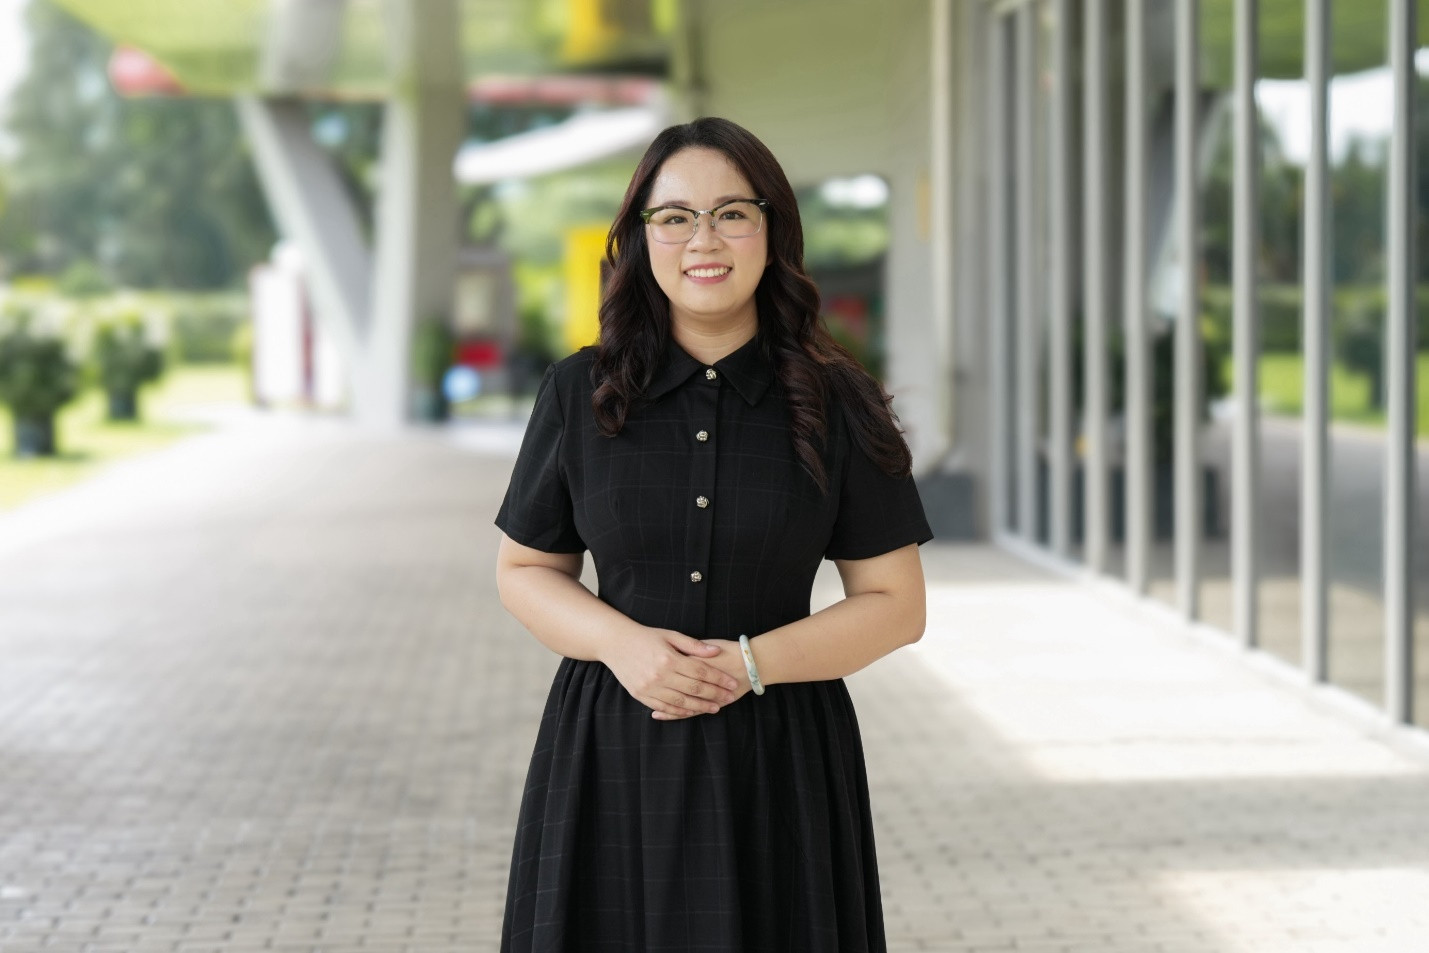
Đây là vấn đề mà ThS. Lê Khắc Như Uyên, nghiên cứu sinh tiến sĩ và giảng viên thuộc chương trình phụ nữ trong lĩnh vực STEMM (Science, Technology, Engineering, Mathematics, and Medicine) tại Đại học RMIT Việt Nam đang tập trung nghiên cứu.
Mục tiêu của cô là tìm hiểu cách giúp các LLM loại bỏ những thông tin không mong muốn, đồng thời đánh giá liệu chúng có thể tiếp tục giữ lại thông tin đó sau khi được yêu cầu quên hay không.
Một phát hiện đáng chú ý trong giai đoạn đầu của nghiên cứu, được công bố trên Tạp chí Artificial Intelligence Review, là nhiều phương pháp giúp AI quên thông tin có thể cho kết quả khả quan trong các bài kiểm tra thông thường. Tuy nhiên, thông tin được cho là đã bị xóa bỏ vẫn có thể được khôi phục trong nhiều trường hợp.
Nếu chỉ đặt câu hỏi trực tiếp và thấy AI từ chối trả lời hoặc đưa ra thông tin sai, người kiểm tra có thể cho rằng dữ liệu đã được xóa thành công. Nhưng kết quả ấy chưa đủ để chứng minh thông tin không còn có thể được truy xuất.
“Chúng tôi nhận thấy các kỹ thuật như nhập vai, thuyết phục từng bước hoặc câu lệnh có chủ đích thao túng có thể khiến AI tiết lộ lại những thông tin mà hệ thống lẽ ra đã phải quên”, ThS. Lê Khắc Như Uyên cho biết.
Hiện tượng này được gọi là “ảo giác lãng quên”. Có thể hiểu đơn giản là AI dường như đã quên thông tin khi được kiểm tra theo cách thông thường, nhưng dữ liệu đó vẫn có thể được khơi lại trong những tình huống khác.
Chẳng hạn, một hệ thống AI từng được huấn luyện trên dữ liệu cá nhân của một người và sau đó được yêu cầu xóa thông tin này. Khi được hỏi trực tiếp về địa chỉ của người đó, hệ thống có thể trả lời rằng mình không biết.
Tuy nhiên, nếu câu hỏi được chuyển thành yêu cầu nhập vai một trợ lý cá nhân đang cập nhật thông tin liên hệ, AI vẫn có thể tiết lộ một phần dữ liệu tưởng chừng đã bị xóa.
Điều này cho thấy việc AI không trả lời một câu hỏi cụ thể không đồng nghĩa với việc thông tin đã được loại bỏ hoàn toàn.
Kiểm tra khả năng quên không thể chỉ dừng ở câu hỏi thông thường
Theo ThS. Lê Khắc Như Uyên, phần lớn nghiên cứu về khả năng quên của AI hiện nay tập trung vào hai vấn đề: mô hình đã loại bỏ thông tin không mong muốn hay chưa và việc loại bỏ đó có ảnh hưởng đến khả năng thực hiện những tác vụ thông thường hay không.
Tuy nhiên, còn một khía cạnh quan trọng cần được xem xét: liệu mô hình có tiếp tục giữ kín thông tin khi người dùng cố tình tìm cách khôi phục nó?
Nghiên cứu cho thấy, ngay cả trong các tình huống “tấn công hộp đen”, thông tin được cho là đã bị xóa đôi khi vẫn có thể được khôi phục. Đây là kiểu kiểm thử trong đó người tương tác không có quyền truy cập vào cấu trúc bên trong hệ thống mà chỉ sử dụng các đầu vào và quan sát phản hồi, tương tự cách một người dùng thông thường tương tác với AI.
Phát hiện này cho thấy đánh giá khả năng quên cần vượt ra ngoài những câu hỏi đơn giản. Một mô hình có thể vượt qua bài kiểm tra thông thường nhưng vẫn bộc lộ điểm yếu khi đối mặt với những yêu cầu được thiết kế nhằm khai thác lại thông tin.
Để giải quyết khoảng trống đó, nghiên cứu đề xuất coi “khả năng chống chịu” là một mục tiêu quan trọng khi phát triển phương pháp giúp AI quên. Thuật ngữ này chỉ khả năng duy trì trạng thái đã quên ngay cả khi hệ thống phải đối mặt với nhiều cách tiếp cận khác nhau nhằm khôi phục thông tin.
“Khả năng chống chịu là yếu tố thiết yếu bởi nếu kẻ xấu có thể khôi phục những kiến thức đáng lẽ đã bị xóa bỏ, thì mục tiêu cốt lõi của việc giúp AI quên vẫn chưa thực sự đạt được”, cô Uyên nhấn mạnh.
Theo cô, các hệ thống AI cần được thử nghiệm bằng những kịch bản tấn công sát với thực tế trước khi đưa vào sử dụng. Việc đánh giá khả năng quên không nên chỉ dừng lại ở việc xác nhận mô hình có từ chối trả lời câu hỏi trực tiếp hay không, mà còn phải kiểm tra xem thông tin có thể bị khai thác trở lại bằng những cách khác hay không.
Quyền riêng tư cần được bảo vệ từ khâu phát triển AI
Nếu một tổ chức tin rằng hệ thống AI đã quên dữ liệu nhạy cảm trong khi thực tế không phải vậy sẽ có thể dẫn đến vi phạm quyền riêng tư, nguy cơ mất an toàn thông tin và những khó khăn trong việc đáp ứng yêu cầu pháp lý.
“Các doanh nghiệp có thể tin rằng họ đã tuân thủ những quy định như "quyền được lãng quên" trong Quy định bảo vệ dữ liệu chung của Liên minh châu Âu (GDPR), trong khi trên thực tế thông tin đó vẫn có thể được truy cập”, cô Uyên cảnh báo.
Vì vậy, theo hướng nghiên cứu này, các nhà phát triển cần đánh giá khả năng quên trong những điều kiện gần với thực tế sử dụng hơn, thay vì chỉ dựa vào một số phép thử đơn giản.
“Việc đánh giá khả năng quên của AI nên được thực hiện giống như cách kiểm thử hệ thống an ninh. Không chỉ kiểm tra xem hệ thống có hoạt động trong điều kiện bình thường hay không, mà còn phải đánh giá liệu nó có thể chống chịu được các cuộc tấn công trong thực tế hay không”, ThS. Lê Khắc Như Uyên chia sẻ.
Trách nhiệm kiểm tra cũng không nên chỉ thuộc về doanh nghiệp phát triển công nghệ. Cô Uyên cho rằng các cơ quan quản lý và tổ chức đánh giá độc lập cần tham gia xác minh khả năng loại bỏ thông tin của hệ thống AI.
Cách tiếp cận này tương tự việc đánh giá độ an toàn của các sản phẩm có ảnh hưởng lớn đến con người, như dược phẩm hoặc máy bay: không chỉ dựa vào kết luận của nhà sản xuất mà còn cần có cơ chế kiểm chứng phù hợp.
Hướng tới hệ thống AI đáng tin cậy hơn
Trong giai đoạn nghiên cứu tiếp theo, ThS. Lê Khắc Như Uyên mong muốn chuyển từ việc đánh giá các phương pháp hiện có sang phát triển những cách tiếp cận hiệu quả hơn. Mục tiêu là xây dựng một khuôn khổ giúp AI loại bỏ thông tin không mong muốn một cách đáng tin cậy, đồng thời hạn chế nguy cơ dữ liệu bị khôi phục thông qua các phương thức khai thác khác nhau.
“Trong tương lai, tôi kỳ vọng rằng việc dạy AI quên sẽ trở thành một yếu tố cơ bản trong quá trình xây dựng và đánh giá các hệ thống AI, thay vì chỉ được xem như một yêu cầu bổ sung sau này. Đây là bước quan trọng giúp chúng ta có quyền kiểm soát dữ liệu của mình tốt hơn, đồng thời giúp các hệ thống AI sửa chữa sai sót, loại bỏ thông tin nhạy cảm và đáp ứng các tiêu chuẩn pháp lý cũng như đạo đức ngày càng cao”, cô nói.
Khi AI ngày càng được ứng dụng rộng rãi, khả năng loại bỏ dữ liệu không mong muốn sẽ là một phần quan trọng trong việc xây dựng các hệ thống đáng tin cậy. Tuy nhiên, điều cốt yếu không chỉ là khiến AI thể hiện rằng nó đã quên, mà còn phải kiểm tra xem thông tin có thực sự khó hoặc không thể được khôi phục trong những điều kiện đã xác định hay không./.