Giải trình tự hệ gen 1.000 mẫu giống lúa Việt Nam phục vụ chọn tạo giống
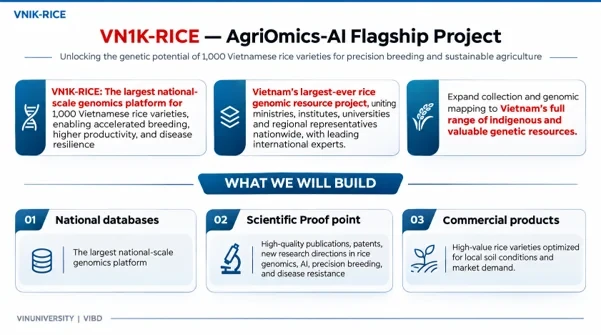
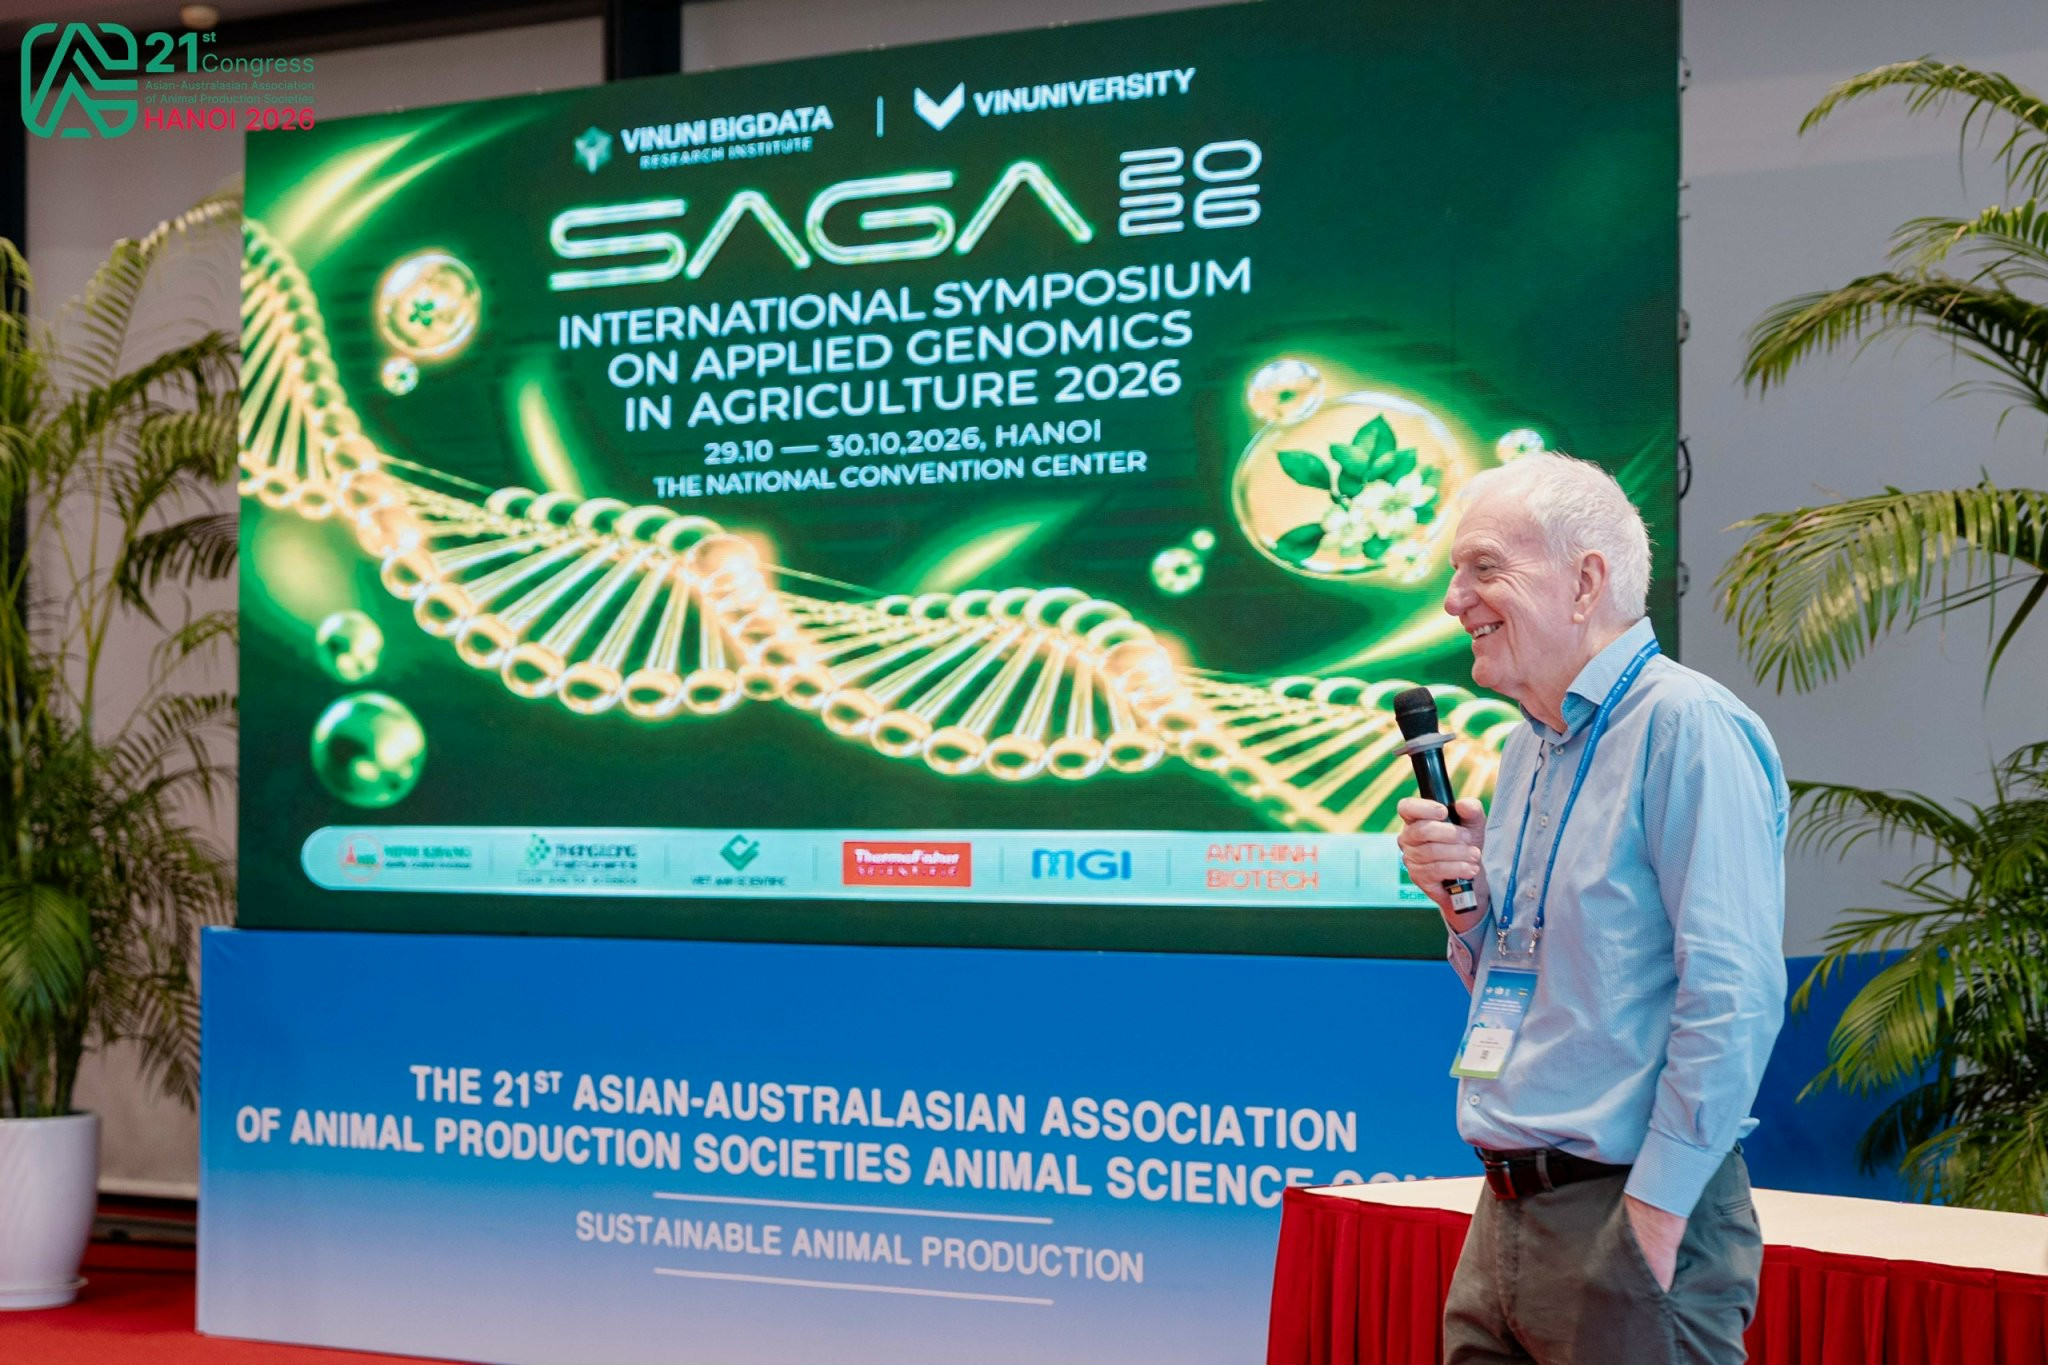
Dự án VN1K-RICE do 2 đơn vị thuộc Tập đoàn Vingroup là Viện Nghiên cứu Dữ liệu lớn (VIBD) và Trường Đại học (ĐH) VinUni giới thiệu tại Hội thảo quốc tế về Ứng dụng công nghệ gen trong nông nghiệp (SAGA 2026), hướng tới xây dựng dữ liệu hệ gen của 1.000 mẫu giống lúa Việt Nam. Nguồn dữ liệu này được kỳ vọng hỗ trợ bảo tồn nguồn gen bản địa và chọn tạo giống lúa có chất lượng cao, thích ứng với biến đổi khí hậu.
Xây dựng dữ liệu di truyền từ nguồn giống lúa bản địa
Tại Việt Nam, nhiều giống lúa truyền thống và lúa hoang đang được lưu giữ tại các ngân hàng gen, viện nghiên cứu và cơ sở đào tạo. Đây là nguồn vật liệu quan trọng cho nghiên cứu, bảo tồn đa dạng di truyền và chọn tạo giống. Tuy nhiên, theo thông tin từ nhóm nghiên cứu, phần lớn nguồn vật liệu này chưa được phân tích đầy đủ ở cấp độ hệ gen. Vì vậy, việc nhận diện và khai thác những đặc tính di truyền có giá trị vẫn gặp nhiều hạn chế.
Được giới thiệu tại SAGA 2026, diễn ra cuối tháng 10/2026 ở Hà Nội, VN1K-RICE (1,000 Vietnamese Rice Genome Project) đặt mục tiêu giải trình tự toàn bộ hệ gen của 1.000 mẫu giống lúa Việt Nam. Dự án dự kiến bắt đầu với nhóm 150 mẫu nòng cốt, sau đó mở rộng quy mô. Bộ mẫu được lựa chọn từ bốn hệ sinh thái: đất lúa nước, đất lúa nương, vùng ven biển nhiễm mặn và đất ngập triều; trong đó có cả các mẫu lúa hoang.
Một nhiệm vụ trọng tâm là xây dựng hệ gen tham chiếu chất lượng cao cho lúa truyền thống Việt Nam. Đây là bộ trình tự DNA chuẩn, dùng để đối chiếu và xác định các biến dị di truyền trong những mẫu lúa khác. Việc có hệ gen tham chiếu phù hợp với nguồn vật liệu bản địa sẽ hỗ trợ phân tích chính xác hơn những khác biệt di truyền, thay vì chỉ dựa vào các hệ gen tham chiếu được xây dựng từ giống lúa ở những khu vực khác.
GS. Robert Henry, ĐH Queensland (Australia), nhà khoa học đồng chủ trì dự án, nhấn mạnh rằng một hệ gen tham chiếu không thể phản ánh đầy đủ sự đa dạng di truyền của cả loài. Do đó, xây dựng dữ liệu tham chiếu gần với nguồn giống đang nghiên cứu có ý nghĩa quan trọng đối với việc khai thác nguồn gen lúa Việt Nam.
Song song với giải trình tự hệ gen, nhóm nghiên cứu dự kiến đánh giá các mẫu giống tại ba vùng sinh thái. Nội dung khảo sát bao gồm chất lượng và dinh dưỡng của gạo (độ dẻo, hương thơm, hàm lượng vi chất và protein); khả năng chịu hạn, chịu mặn, chịu nóng, chịu ngập; khả năng kháng một số bệnh phổ biến; cùng lượng phát thải hai khí nhà kính CH₄ và N₂O trong canh tác. Dữ liệu thực địa có vai trò thiết yếu, bởi biểu hiện của nhiều tính trạng phụ thuộc đồng thời vào đặc điểm di truyền và điều kiện môi trường.
Từ dữ liệu hệ gen đến ứng dụng trong chọn tạo giống
Khi dữ liệu hệ gen được kết hợp với kết quả đánh giá tính trạng và điều kiện canh tác, các nhà khoa học có thể tìm kiếm những vùng gen liên quan đến chất lượng hạt gạo, khả năng chống chịu hoặc mức phát thải. Theo kế hoạch, dự án sẽ xây dựng cơ sở dữ liệu (CSDL) về các biến thể đơn nucleotide (SNP) - những khác biệt tại một vị trí trong trình tự DNA giữa các mẫu giống, đồng thời thu thập dữ liệu biểu hiện gen để phục vụ phân tích chức năng của gen.
Trên nền tảng đó, trí tuệ nhân tạo (AI) được kỳ vọng hỗ trợ xử lý khối lượng dữ liệu lớn, phát hiện các mẫu hình di truyền và dự đoán mối liên hệ giữa trình tự DNA với tính trạng. Tuy nhiên, những gen hoặc vùng gen được xác định từ phân tích dữ liệu vẫn cần được kiểm chứng bằng nghiên cứu thực nghiệm và khảo nghiệm trong điều kiện sản xuất phù hợp.
Chẳng hạn, nếu một mẫu lúa bản địa thể hiện khả năng chịu mặn tốt, dữ liệu hệ gen có thể giúp khoanh vùng những biến dị di truyền liên quan để nghiên cứu khả năng sử dụng trong lai tạo. Tương tự, các mẫu giống có hương thơm hoặc chất lượng gạo nổi bật có thể cung cấp vật liệu di truyền cho mục tiêu cải thiện chất lượng sản phẩm. Các chỉ thị phân tử từ dữ liệu DNA sẽ hỗ trợ sàng lọc vật liệu giống ngay từ những giai đoạn đầu, qua đó bổ sung công cụ cho phương pháp chọn giống truyền thống.
Dự án còn hướng tới phát triển các dòng lúa gần đẳng gen, tức những dòng có nền di truyền gần như tương đồng nhưng khác nhau ở vùng gen mục tiêu. Đây là vật liệu hữu ích để kiểm chứng vai trò của những vùng gen được phát hiện trước khi đưa vào chương trình lai tạo. Cùng với đó, hệ thống chỉ thị phân tử có thể góp phần nhận diện và xác thực các giống lúa mang đặc tính mong muốn.
VN1K-RICE thuộc chương trình nghiên cứu AgriOmics-AI giai đoạn 2026-2030 của VIBD, kết hợp dữ liệu hệ gen với AI nhằm nghiên cứu và khai thác nguồn gen bản địa ở cây trồng, vật nuôi, thủy sản và vi sinh vật có lợi. Theo GS. Vũ Hà Văn, Giám đốc khoa học VIBD, một mục tiêu của chương trình là chuyển các bộ sưu tập nguồn gen đang được lưu giữ thành dữ liệu có thể phân tích, chia sẻ và ứng dụng trong chọn giống.
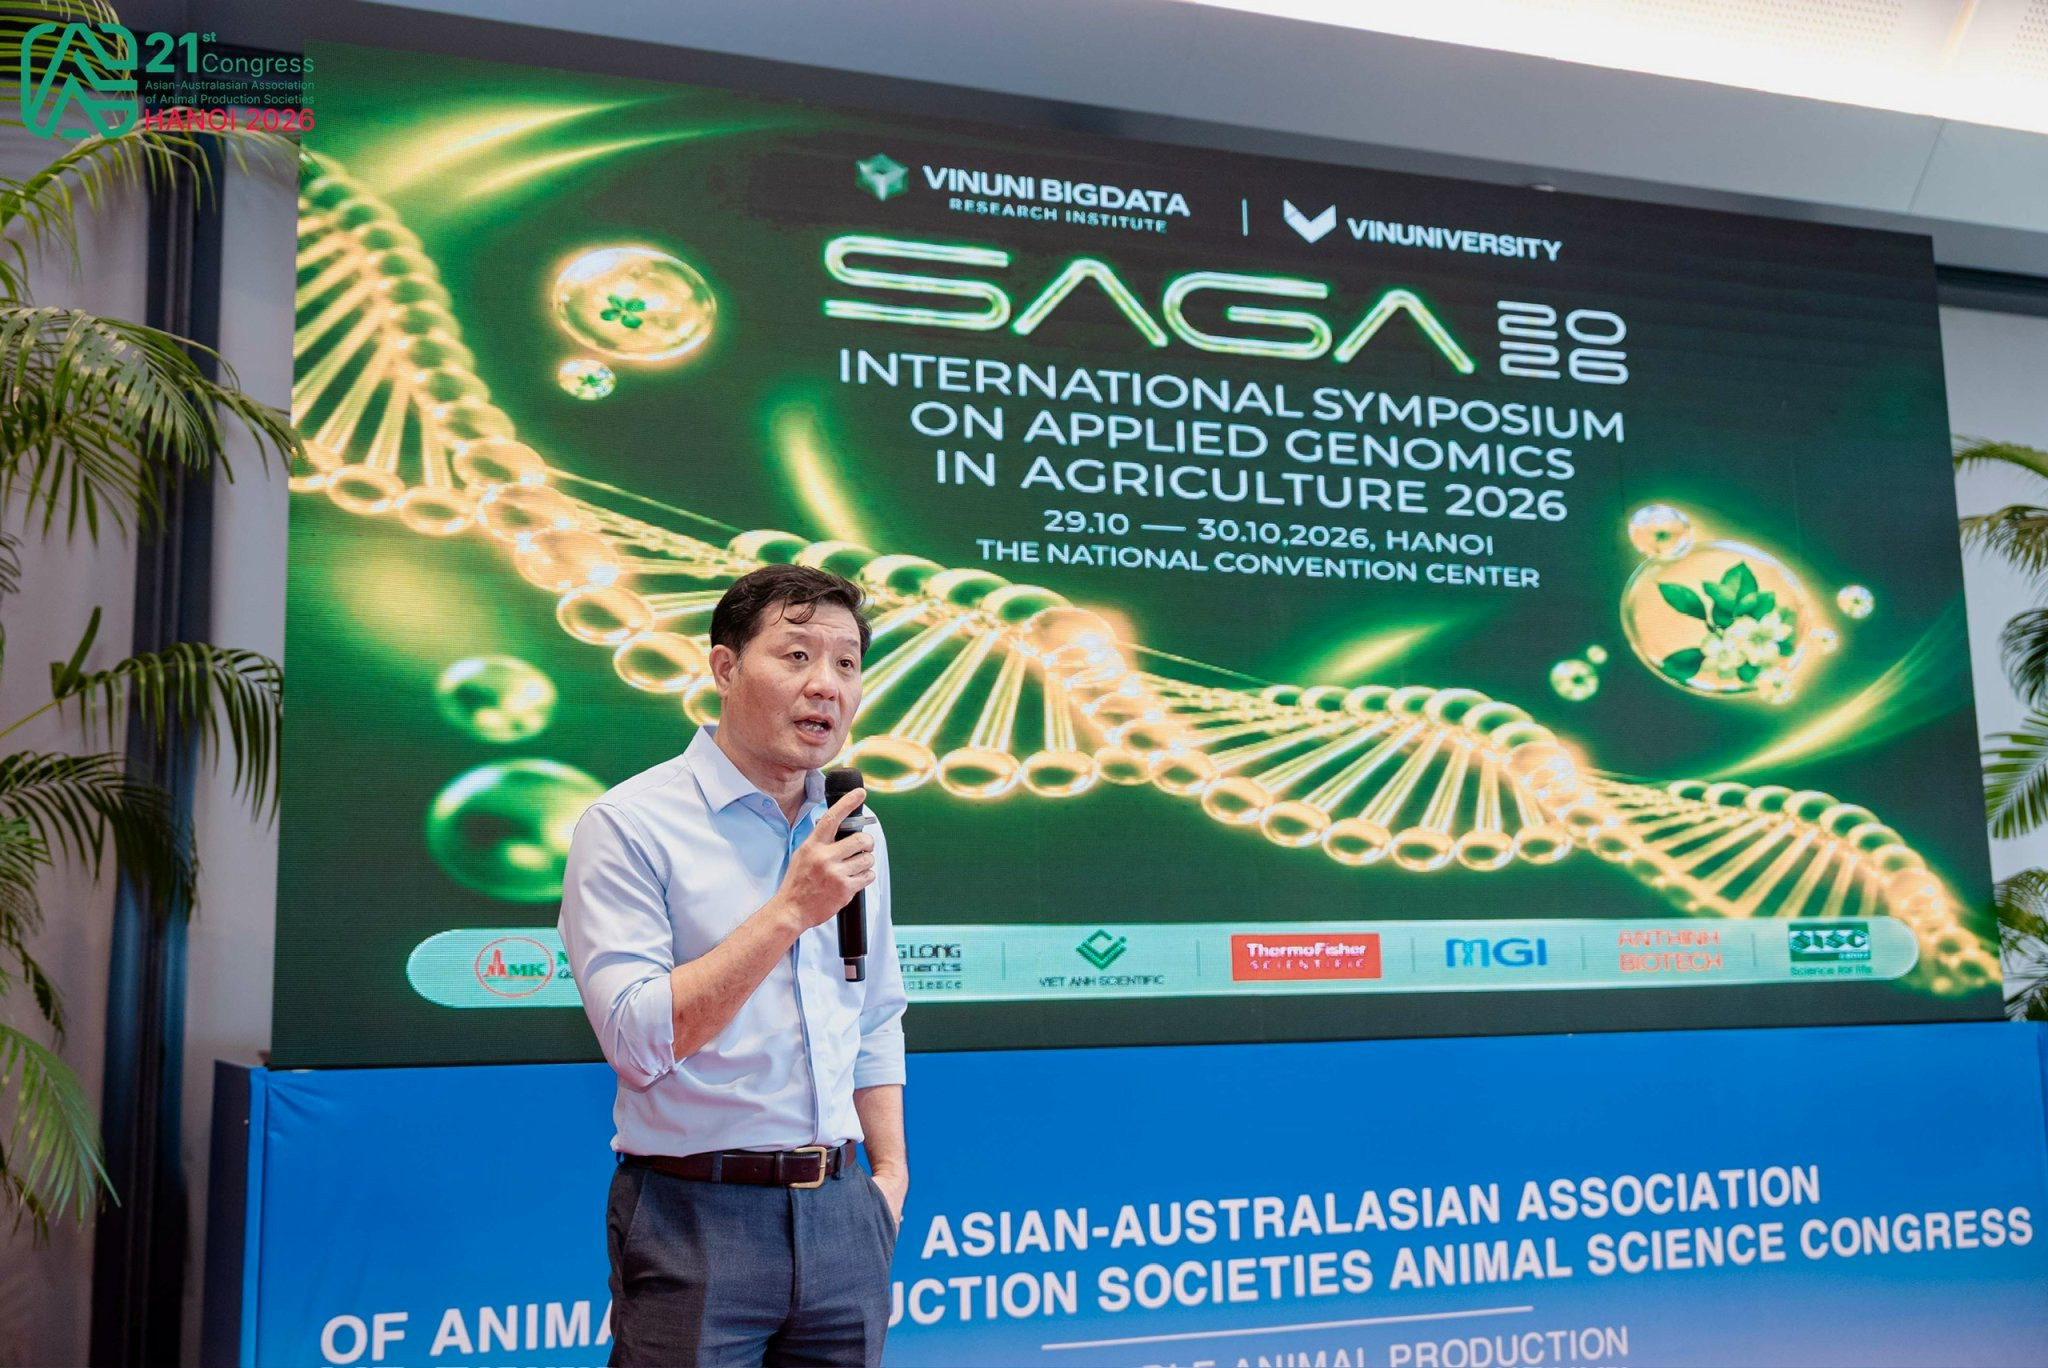
Nếu được xây dựng, chuẩn hóa và chia sẻ hiệu quả, CSDL của VN1K-RICE không chỉ phục vụ một dự án riêng lẻ mà còn có thể trở thành nguồn tư liệu chung cho các nhóm nghiên cứu và cơ sở chọn tạo giống.
Về dài hạn, GS. Vũ Hà Văn cho rằng giá trị của dự án sẽ phụ thuộc vào chất lượng dữ liệu, khả năng xác thực các kết quả phân tích và mức độ chuyển giao vào hoạt động nghiên cứu, lai tạo thực tế. Đây là những điều kiện để dữ liệu hệ gen góp phần phát triển các giống lúa có giá trị cao, thích ứng tốt hơn với điều kiện bất lợi và hướng tới sản xuất nông nghiệp phát thải thấp./.